自动化的门槛不是准确率,是模型知不知道自己哪次会错 正文
从 TypeSafe 发布的不聊天模型 Jev 说起
2026 年 9 月 15 日,一家叫 TypeSafe AI 的公司结束两年隐身,发布了它的第一个模型 Jev。这个模型不聊天,也不生成文本,只做一件事:读入一段非结构化的状态,输出一组带概率的结构化判断。创始人 Diogo Almeida 自述曾在 OpenAI 参与让语言模型学会跟随指令的研究,那项工作后来成了 ChatGPT 背后的研究之一。这样一个人,做出的第一个产品却把文本生成整个去掉了。他给出的理由是一个追问:模型在聊天上超过人类已经好几年,说好的自动化在哪里?
给人看的模型,和给软件用的模型
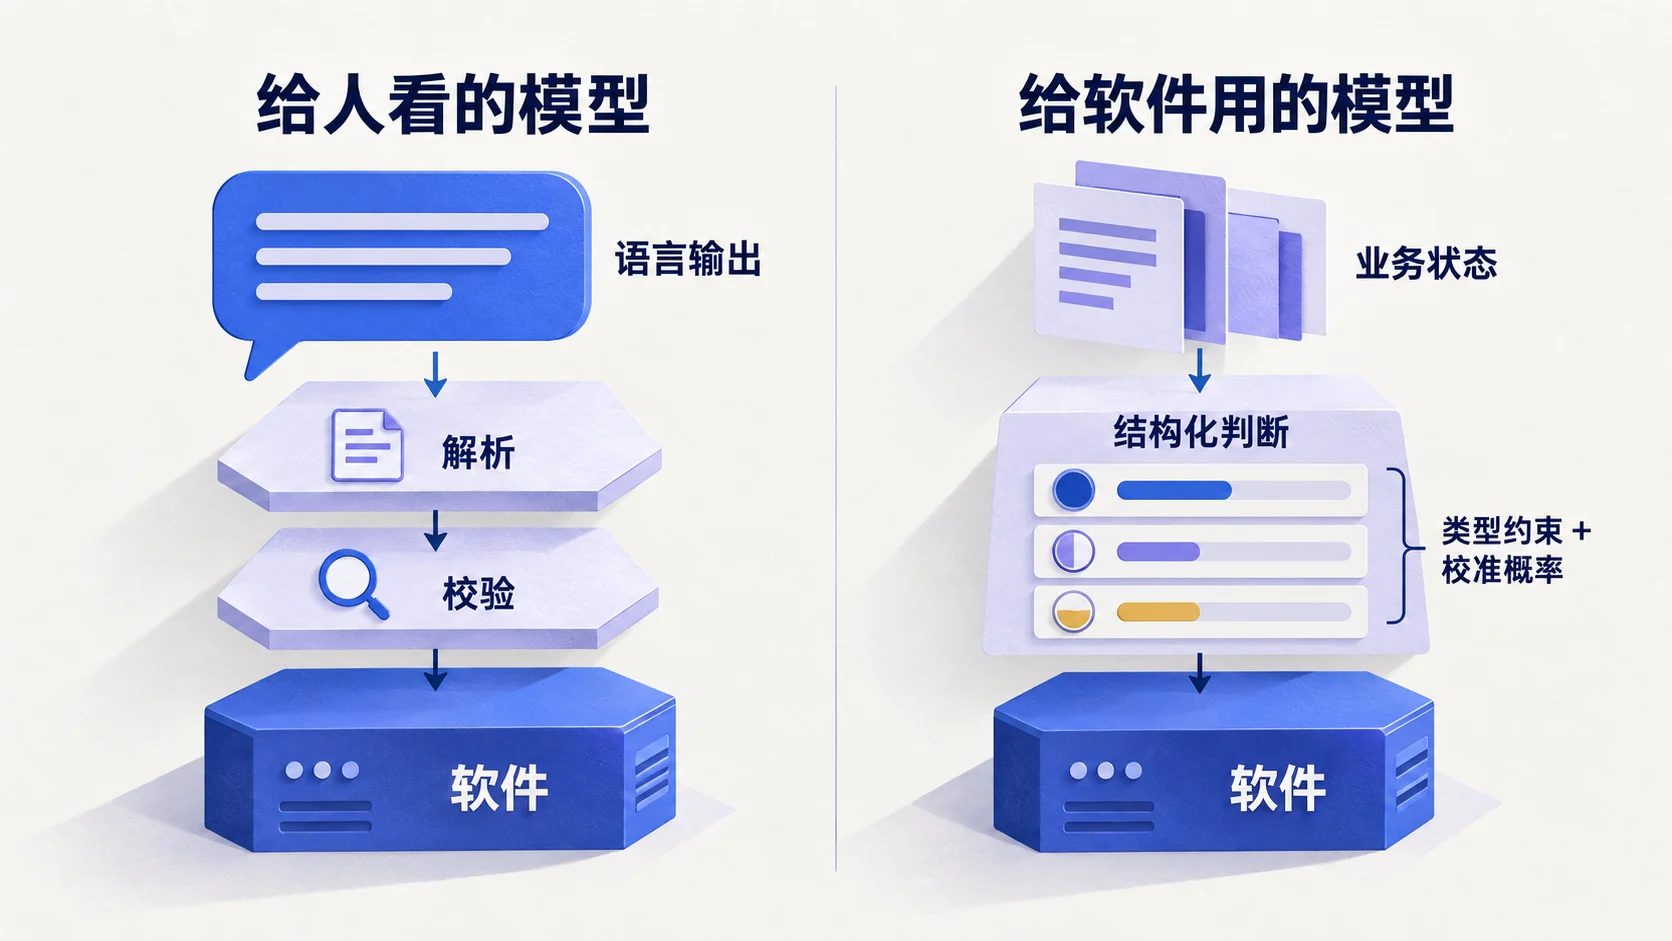
大模型的输出是字符串:一段话、一段代码、一个 JSON。字符串对人友好,对软件不友好。软件拿到它要先解析、再校验,还要防着模型偶尔越界。大模型又是逐词生成的,每个词依赖前一个词,TypeSafe 引用的一项外部测量显示,前沿模型一次完整回答的端到端时间在 3 秒到 329 秒之间。和人聊天足够,嵌进代码里、一条流程调用几十次,就成了瓶颈。
Jev 换了一种接口。输入是一段状态,比如一条工单、一段对话、一个订单快照;输出是调用方事先用 schema 定义好的一组判断,每个判断带一个经过校准的概率。因为取值范围事先定死,模型不可能给出 schema 之外的东西,类型错误在数学上不成立;因为所有字段一次并行算出,不必逐词生成,厂商公布的端到端时延是 70 到 500 毫秒。TypeSafe 把它概括成一句话:前沿智能的函数调用。
价格上,输入每百万 token 0.042 美元,输出不收费。首页写的“快 193.6 倍、便宜 444.6 倍”出自它自建的工作流评测,发布稿自己注明这是真实收益的上限:参考答案取的是 GPT-6 Astra 和 Fable 5.1 两个模型输出的平均,因此对这两家更有利。这些都是厂商口径,目前还没有第三方的基准测试。
真正的门槛:模型知不知道自己哪次会错
发布稿里最值得企业记住的不是速度,是一句关于置信度的话:一个模型如果 95% 的时候能做对,却说不出自己什么时候处在那 5% 里,这个任务就没法交给它自动完成。
这句话点破了企业自动化的真实门槛。有人盯着的时候,模型错 5% 无所谓,人会抓住;没有人盯着的时候,这 5% 会原样执行下去。所以决定能不能拿掉人的,不是把准确率从 95% 提到 97%,而是模型能不能在没把握的时候举手。大模型即使被要求报一个置信度,往往也过度自信、前后不一致,它自报的把握不能拿来分流。TypeSafe 的训练方法叫 RLCD,全称是 Reinforcement Learning for Calibrated Decisions,优化目标就是让概率如实反映把握:置信度高的时候,准确率确实高;相似的输入,给出相似的答案。
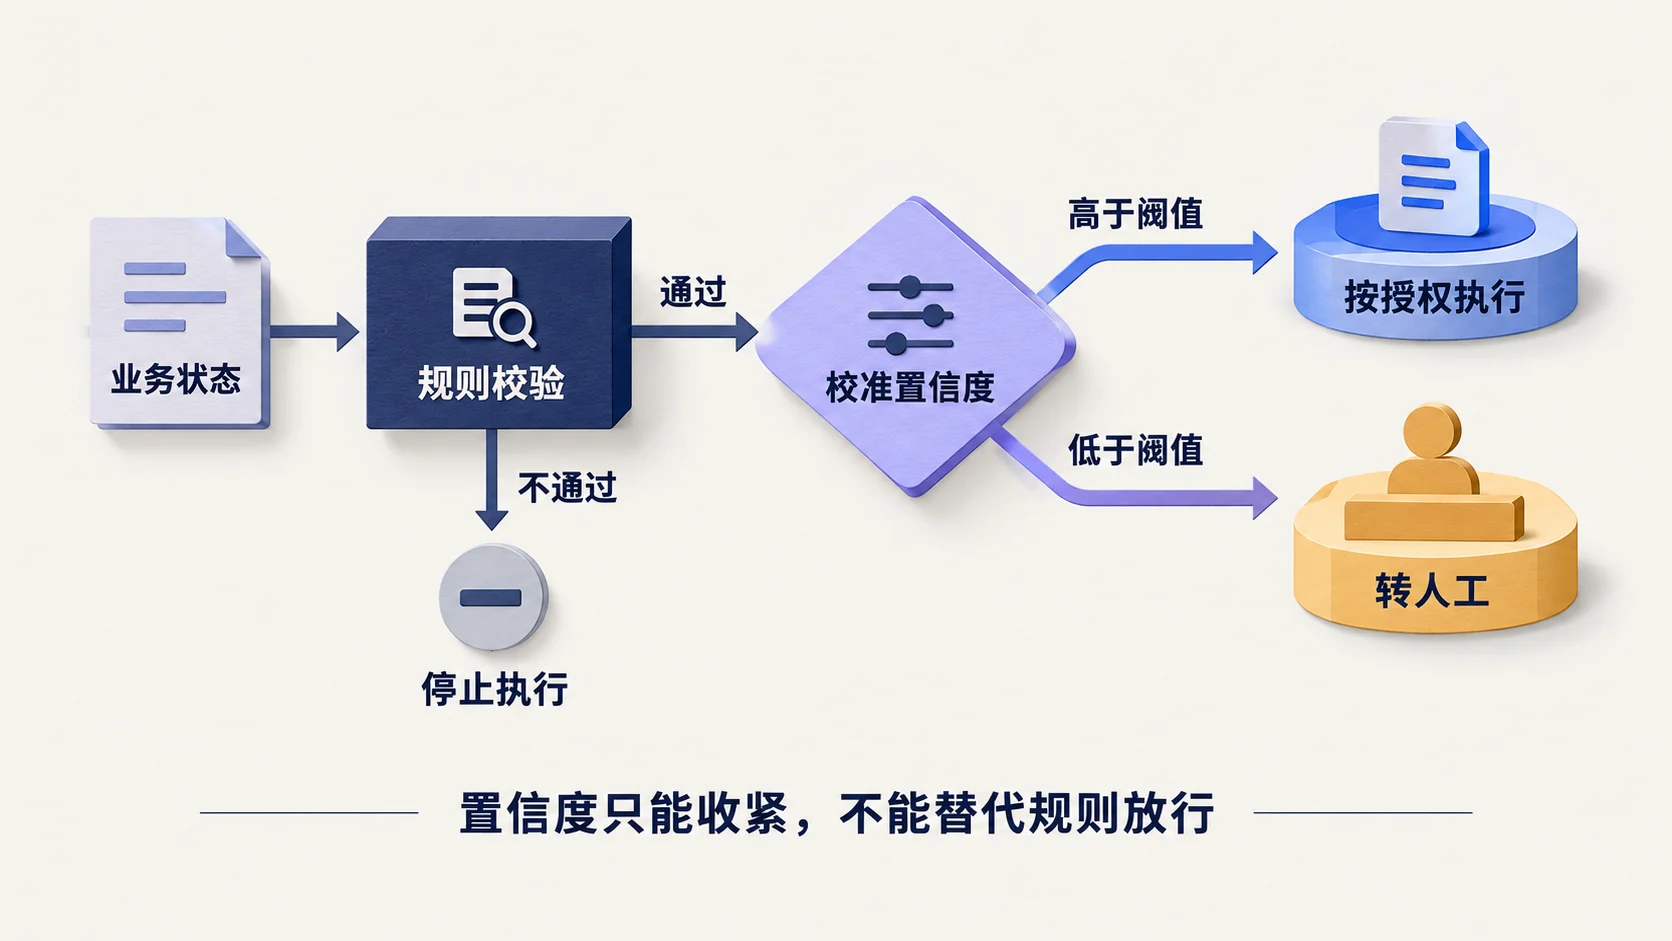
一旦置信度可信,人工审核就可以从“全审”或“不审”变成按把握程度配置:高于阈值自动执行,低于阈值转人工,转人工的比例和批准率反过来告诉系统阈值该不该动。自动化率不再是上线时拍板的一个数字,而是随着记录增长的过程。
它替代的是什么:工作流里的“智能 if 语句”
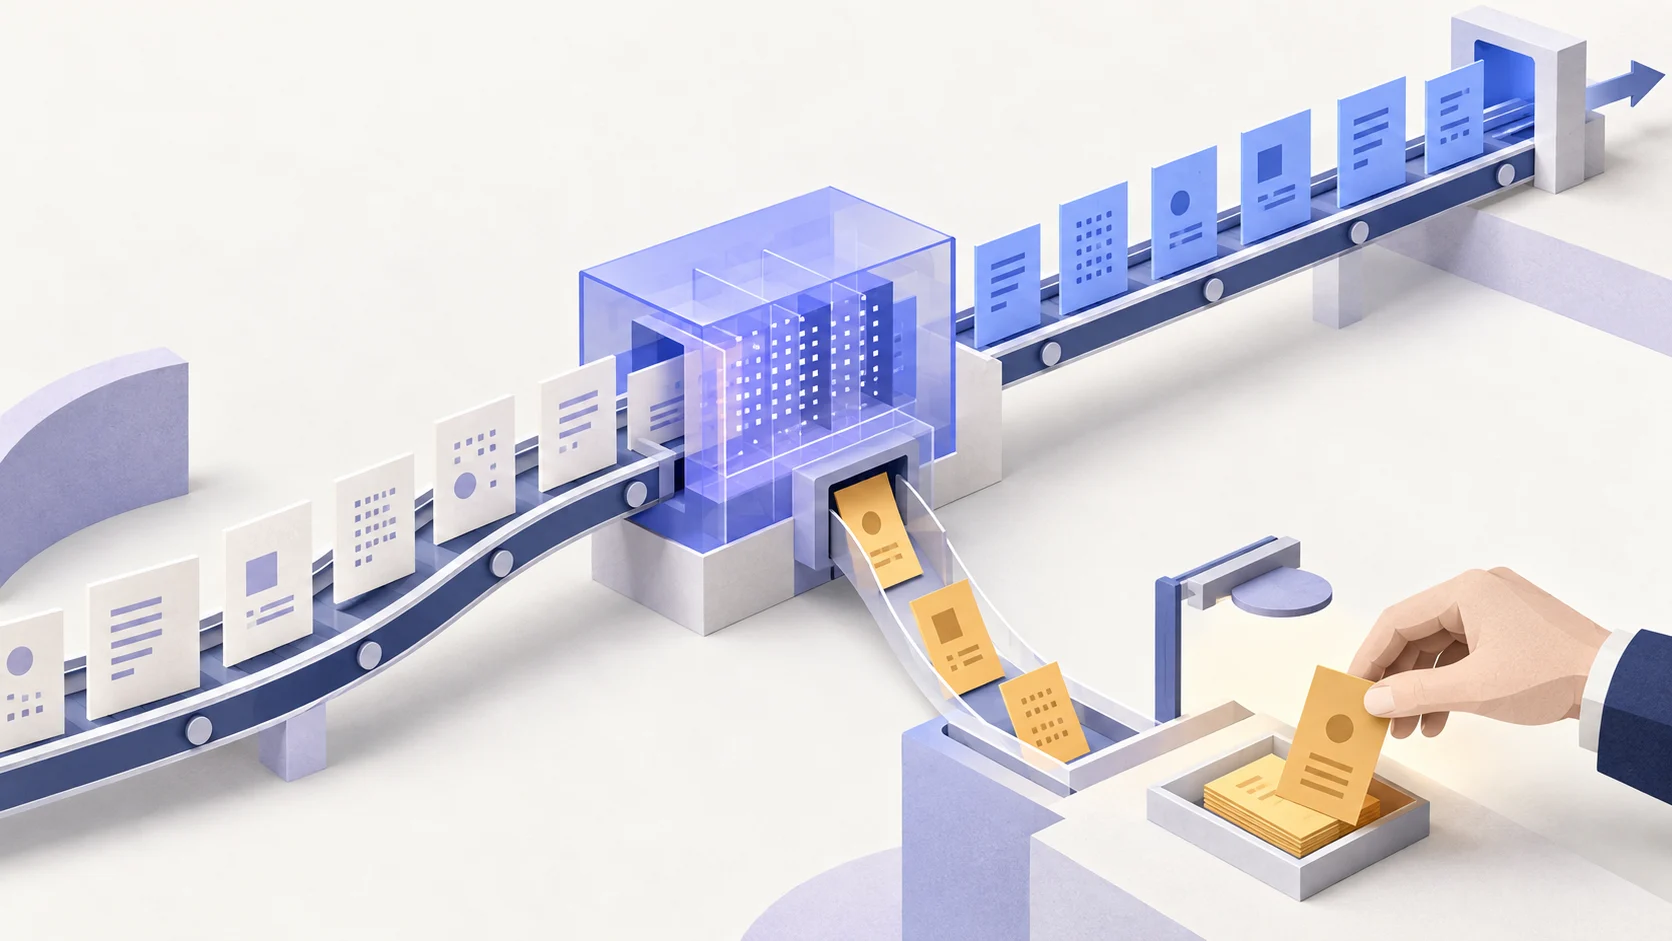
一条企业流程里,真正需要大模型写东西的节点很少,大多数节点是判断:这条客诉属于哪一类,情绪激不激烈,该不该转人工,这条线索打几分,这份材料缺不缺字段。TypeSafe 把这类用法叫“智能 if 语句”:结构化的判断嵌进普通代码,充当一条模糊的判断规则,周围的代码约束它的自由度。此外还有三类场景:对海量数据做 map-reduce 提特征,百毫秒级的实时应用,以及给别的大模型当裁判,打分、评判、做护栏、检测越狱。
它放弃的是另一半:写文案、写代码、和人对话,这些仍然是大模型的地盘。
第三方的试用也印证了这个定位。Every 的作者 Mike Taylor 在发布当天做了 11 组实验,在一次测试里用 37 篇文档做了 777 次判断,用时不到 0.7 秒,费用约四分之一美分;和 Fable 5.1 对比,他测得约快 25 倍、便宜约 580 倍,但准确率更低:7 处故意埋下的写作缺陷,Jev 找到 6 处,对照模型全部找到。他的结论是,可以当早期预警系统,进生产前还要做更严格的准确率检查。换句话说,“不会幻觉”只在类型层面成立,判断本身照样会错,校准的意义是它会告诉你哪一次把握不大。
我们的判断
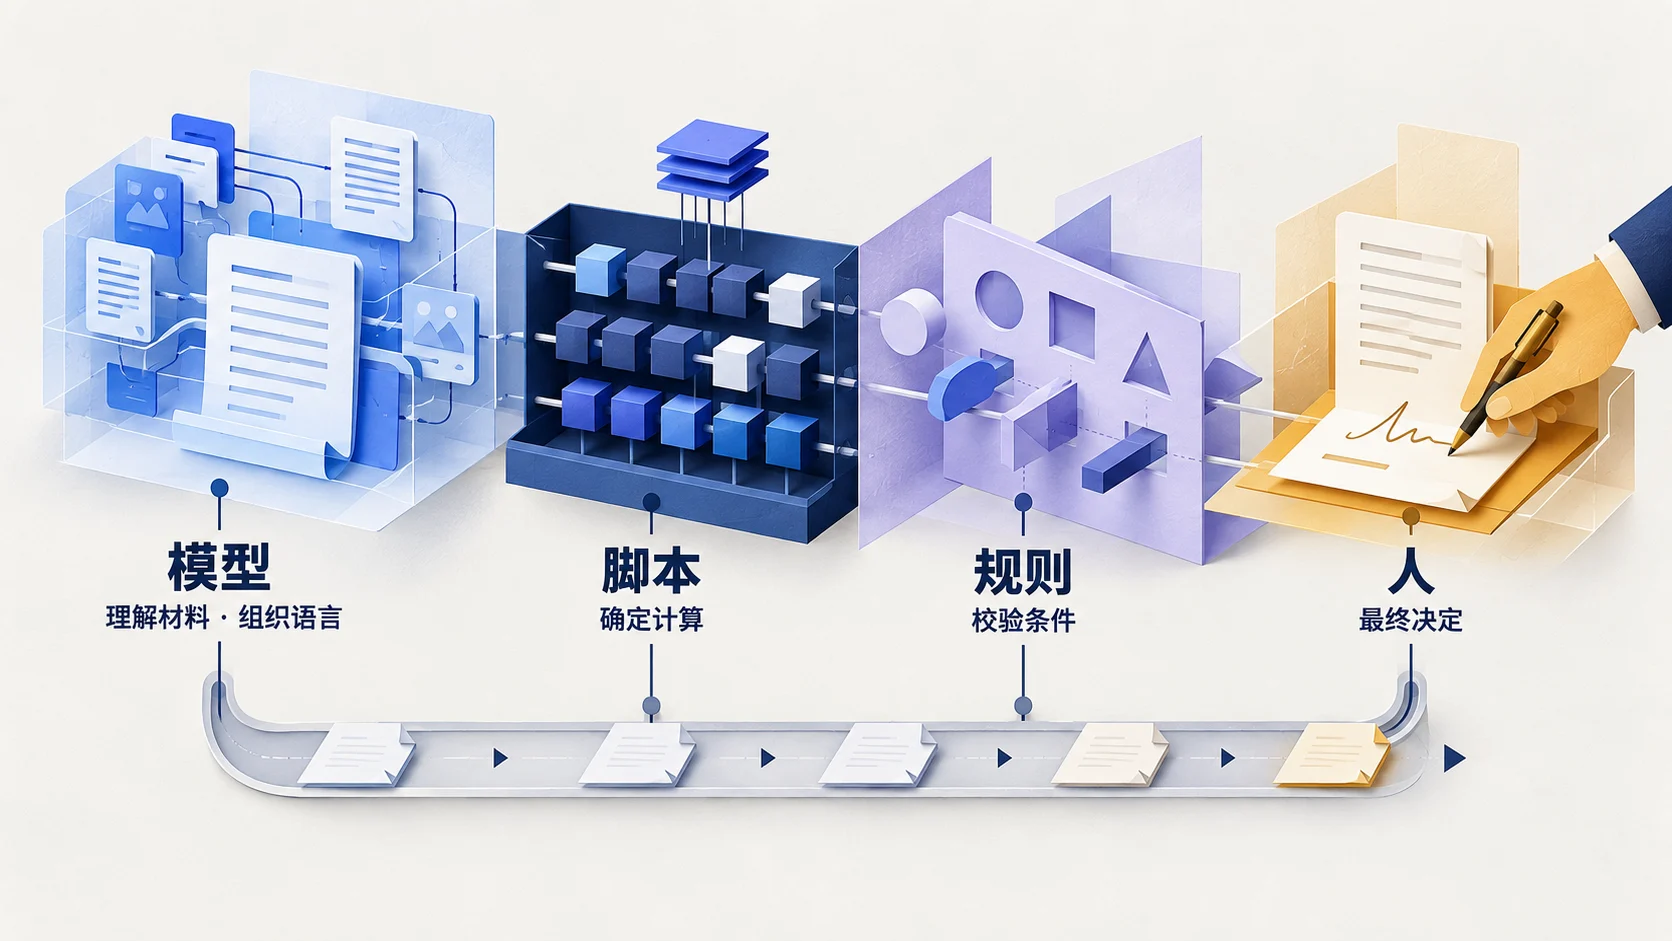
我们在企业项目里坚持一条分工:模型负责理解材料、组织语言、检索关联;计算交给脚本,条件判断交给规则,最终决定交给人。让 Agent 替人执行动作时,这条分工要收得更紧:动作的前置条件必须绑定确定性实现,同样的输入必然得到同样的真假,不允许模型看着办。
Jev 这类决策模型没有推翻这条原则,而是补上了原来最难处理的一块:那些写不成规则、原本只能让大模型看的判断。这类判断可以交给决策模型,概率写进记录,作为人工闸门的阈值;它只能收紧,把没把握的交给人,不能替代确定性规则去放行。模型越便宜、越快,这个用法越划算。TypeSafe 用经济学家 Jevons 给模型命名,取的正是这个意思:智能的成本每降一个数量级,值得自动化的判断就多几个数量级。
一家公司的发布稿改变不了行业,但它把一个方向说清楚了:AI 进入企业的下一步,不是让模型答得更多、更像人,而是让它在每一个判断上如实报出把握,再由系统决定哪些判断可以交给它。